
Die Definition von Redundanz in der IT ist einfach: Wichtige Komponenten oder Systeme sind zusätzlich vorhanden, damit bei einem Ausfall eine Alternative übernehmen kann. Das kann zum Beispiel einen Server, eine Stromversorgung oder eine Netzwerkverbindung betreffen.
Redundanz kann Ausfälle abfedern – sie verhindert aber nicht automatisch jede Betriebsunterbrechung. Entscheidend ist, welche Komponenten doppelt vorhanden sind und ob sie unabhängig voneinander ausfallen können.
Redundanz einfach erklärt: Was bedeutet Redundanz in der IT?
Was heißt Redundanz eigentlich? Im allgemeinen Sprachgebrauch beschreibt der Begriff etwas, das mehrfach vorhanden ist, obwohl man es für die reine Funktion nur einmal bräuchte.
In der IT ist dieses „Zuviel“ gewollt. Unter Redundanz versteht man hier das bewusste Vorhalten zusätzlicher Komponenten, Verbindungen oder Datenbestände. Sie bleiben im Normalbetrieb oft im Hintergrund oder teilen sich die Last mit dem Hauptsystem. Fällt das Hauptsystem aus, übernehmen sie seine Aufgabe.
Einfach erklärt in einem Satz: Redundanz bedeutet, dass für kritische Teile einer IT-Infrastruktur ein Ersatz bereitsteht, der bei einem Ausfall einspringt.
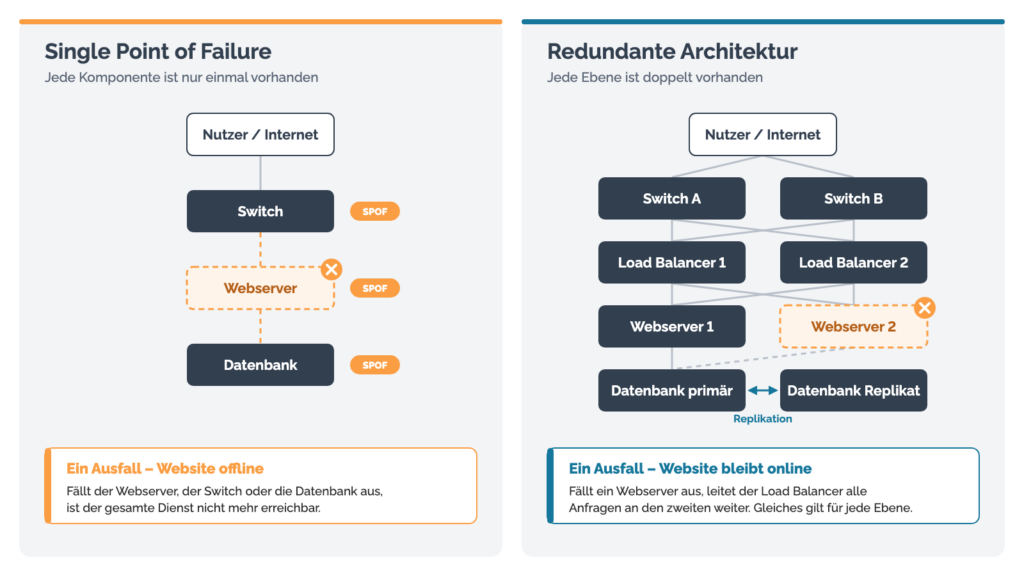
Was Redundanz in der Praxis wert ist, misst sich an der Verfügbarkeit, also daran, wie zuverlässig Systeme und Dienste erreichbar bleiben. Das Ziel ist, sogenannte Single Points of Failure zu vermeiden. Gemeint sind einzelne Komponenten, deren Ausfall ein ganzes System lahmlegt.
Welche Arten technischer Redundanz gibt es?
Technische Redundanz kann an mehreren Stellen einer IT-Infrastruktur ansetzen. Welche Variante sinnvoll ist, hängt davon ab, welche Ausfälle abgefangen werden sollen. Häufige Formen der Redundanz in der Technik sind:
- Server- und Systemredundanz: Ein zweiter Server kann einen ausgefallenen Dienst übernehmen – vorausgesetzt, der Wechsel ist eingerichtet, etwa über ein Standby-System oder einen Load Balancer. Ein zusätzlicher Server allein garantiert noch keine automatische Übernahme. Man unterscheidet dabei zwischen Active-Passive-Modellen (ein Standby-System übernimmt erst im Fehlerfall per Failover) und Active-Active-Clustern (mehrere Knoten teilen sich dauerhaft die Last).
- Netzwerkredundanz: Mehrere Netzwerkverbindungen schaffen alternative Wege für den Datenverkehr. Damit sie bei einem Leitungsschaden wirklich helfen, sollten sie möglichst nicht dieselbe Trasse oder andere gemeinsame Schwachstellen haben.
- Stromversorgungsredundanz: Eine USV überbrückt kurze Stromausfälle oder ermöglicht ein kontrolliertes Herunterfahren. Zusätzliche Netzteile oder getrennte Stromzuführungen können den Schutz erweitern, sofern sie nicht von derselben Fehlerquelle abhängen.
- Speicherredundanz: Verfahren wie RAID können den Ausfall eines Datenträgers abfangen. Ein unabhängiges Backup ersetzen sie aber nicht – es bleibt ein zentraler Baustein der Datensicherheit, etwa bei versehentlichem Löschen oder einem Sicherheitsvorfall.
Entscheidend ist, dass die redundanten Komponenten nicht gleichzeitig durch denselben Fehler ausfallen können.
Welche Beispiele für Redundanz gibt es in der IT?
Ein konkretes Redundanz-Beispiel in der IT ist eine Website, die auf zwei Webservern läuft. Ein Load Balancer verteilt die Anfragen und kann sie an den verfügbaren Server weiterleiten, wenn einer ausfällt. Das setzt voraus, dass der Wechsel eingerichtet ist und keine gemeinsam genutzte Komponente – etwa eine einzelne Datenbank oder ein einzelner Netzwerk-Switch – zum Ausfallpunkt wird.
Redundanz im Alltag kennt man vom Reserverad: Es hilft, nach einer Reifenpanne weiterzufahren. Auch in der IT braucht es eine einsatzbereite Alternative. Zwei Server im selben Raum können gegen den Defekt eines Servers schützen, aber nicht automatisch gegen einen Brand oder Stromausfall am Standort. Wie weit die Redundanz reichen muss, hängt also davon ab, welches Risiko abgefangen werden soll.
Redundanz und Georedundanz: Wo liegt der Unterschied?
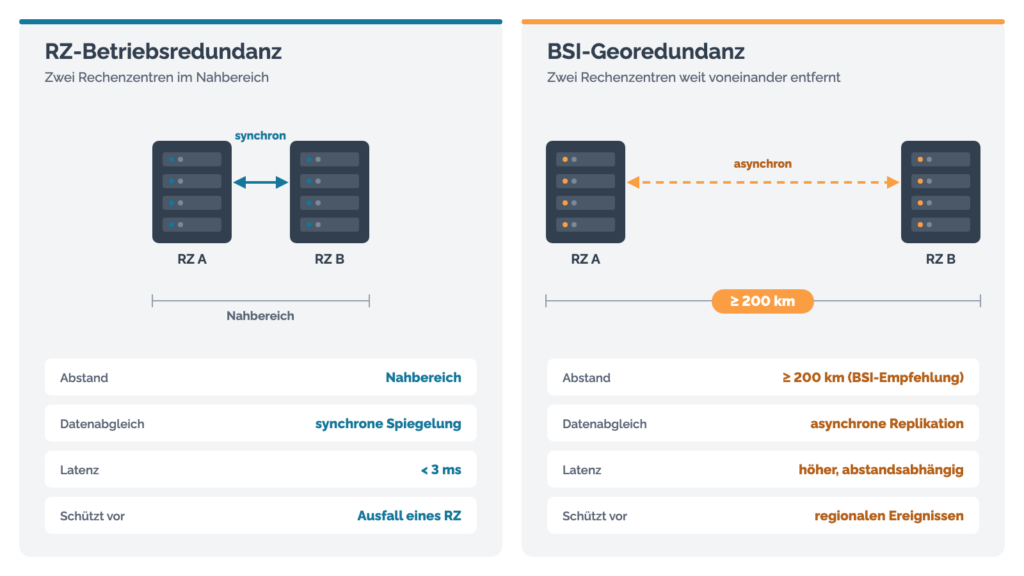
Klassische Redundanz sichert einzelne Komponenten oder Systeme ab, meist innerhalb eines Rechenzentrums. Ein zweites Netzteil, ein gespiegelter Datenträger oder ein Standby-Server fangen technische Defekte ab. Sie helfen aber nicht, wenn der gesamte Standort ausfällt, etwa durch Hochwasser, einen Großbrand oder einen flächigen Stromausfall.
Hier setzt Georedundanz an: IT-Systeme werden in mindestens zwei voneinander entfernten Rechenzentren vollständig und unabhängig betrieben. Das Bundesamt für Sicherheit in der Informationstechnik (BSI) empfiehlt dafür in seinen Kriterien für die Standortwahl von Rechenzentren einen Mindestabstand von 200 Kilometern. Eine kürzere Distanz von bis zu 100 Kilometern hält das BSI nur mit schriftlicher Begründung und Risikoanalyse für vertretbar.
Die räumliche Trennung hat einen Zielkonflikt: Je größer der Abstand, desto besser der Schutz vor regionalen Ereignissen. Gleichzeitig steigt die Latenz, sodass Daten über diese Distanz in der Regel asynchron gespiegelt werden. Für den Nahbereich verwendet das BSI den Begriff RZ-Betriebsredundanz.
Wie die BSI-Kriterien im Detail aussehen, erklären wir im Beitrag Was ist Georedundanz nach BSI? Welche Rolle Redundanz, Backups und Notfallplanung beim Schutz vor Störungen spielen, zeigt unser Beitrag Ausfälle und Risiko: Wie Sie Ihre Infrastruktur absichern.
Häufige Fragen zur Redundanz – FAQ
Was bedeutet Redundanz in der IT?
Redundanz bedeutet in der IT, dass wichtige Komponenten wie Server, Netzwerkverbindungen, Stromversorgung oder Speicher zusätzlich vorhanden sind. Fällt ein Teil aus, übernimmt die Alternative. So bleiben Systeme und Dienste verfügbar, obwohl ein Element gestört ist.
Was ist mit Redundanz gemeint?
Unter Redundanz versteht man allgemein das mehrfache Vorhandensein von etwas, das für die reine Funktion nur einmal nötig wäre. Was man unter einer Redundanz versteht, hängt vom Fachgebiet ab: In der Technik und IT ist damit ein gezielt eingeplanter Ersatz gemeint, der Ausfälle abfedert.
Was bedeutet redundant auf Deutsch?
„Redundant“ heißt auf Deutsch „mehrfach vorhanden“ oder „überreichlich“. Der Begriff leitet sich vom lateinischen „redundare“ (überlaufen, im Überfluss vorhanden sein) ab. Im IT-Kontext ist das „Zuviel“ jedoch nicht überflüssig, sondern eine bewusste Absicherung.
Welche Beispiele gibt es für Redundanz?
Typische Beispiele für Redundanz in der IT sind:
- zwei Netzteile in einem Server
- gespiegelte Festplatten im RAID-Verbund
- zwei Internetanbindungen über getrennte Trassen
- ein zweites Rechenzentrum für den Notfall
Was bedeuten N+1- und 2N-Redundanz im Rechenzentrum?
Diese Kennzahlen beschreiben das Ausmaß der Absicherung kritischer Infrastruktur (wie USV-Anlagen, Klimatisierung oder Strompfade). N+1 bedeutet, dass zusätzlich zu den für den Normalbetrieb benötigten Komponenten (N) mindestens eine unabhängige Reserveeinheit (+1) bereitsteht. 2N steht für die vollständige Verdopplung der gesamten Infrastruktur – etwa über zwei getrennte Stromversorgungsstränge (A- und B-Feed), sodass selbst bei Wartung oder Totalausfall eines Strangs der Betrieb unterbrechungsfrei weiterläuft.
Keine Single Points of Failure in Ihrer Infrastruktur
Ob hochverfügbare Proxmox-Cluster, redundante A/B-Stromversorgung in unseren ISO-27001-zertifizierten Rechenzentren oder mehrfache Glasfaseranbindungen über getrennte Trassen: NMMN plant und betreibt Ihre IT-Infrastruktur ohne kritische Einzelausfallpunkte. Lassen Sie uns gemeinsam prüfen, wie ausfallsicher Ihre Systeme heute aufgestellt sind – vereinbaren Sie jetzt ein unverbindliches Beratungsgespräch.
Lars Sommerfeldt
Geschäftsführer, NMMN